Zichuan Xu
Data Brainが必要な情報を渡しても、受け取ったAIが答えを出し切れなければ仕事は進みません。手元で動く小さなモデルでは、考えている途中で同じ文章を繰り返し、出力の上限まで使ってしまうことがあります。
今回紹介する CLC-sel は、モデル自身の出力から「考え終わるときの状態」を見つけ、重みのごく一部を調整する研究です。Qwen3.5-0.8Bの思考モードを対象に、答えを出す前に止まっていた問題を、最後まで解答できるか調べました。
考え続けて、答えに届かない
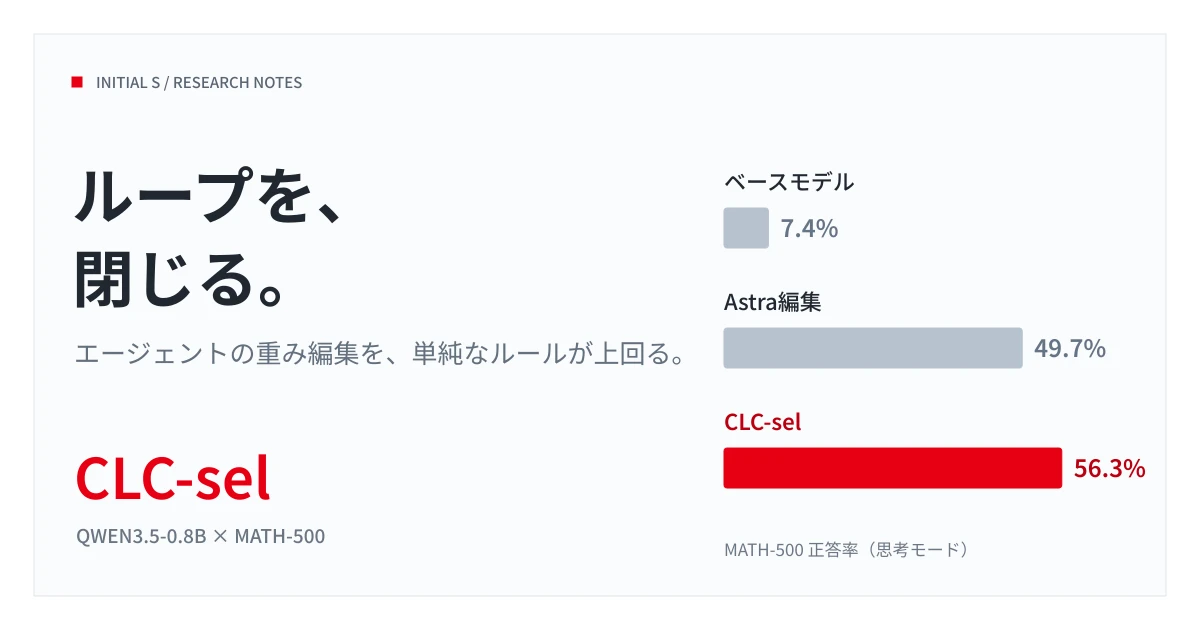
数学問題MATH-500では、編集前のモデルは93%の回答が32,768トークンの上限で打ち切られ、正答率は7.4%でした。文章を長く生成していても、最終的な答えに届いていなかったのです。
先行研究では、GPT-6 AstraというAIエージェントが約20時間かけてモデルの重みを調べ、小さな変更を作りました。その編集で、正答率は49.7%まで上がっています。
ここから考えたのが、「見つかった仕組みを、決まった手順で適用できないか」という問いです。毎回エージェントに長く探索させる代わりに、モデルの出力を調べて編集を作る方法を試しました。
繰り返し中と、書き終える直前を比べる
最初は、文章を繰り返している信号を弱める方向を試しました。しかし、その正答率は23.2%にとどまりました。
先行研究の編集を詳しく見ると、思考を終えるための出力が強くなっていました。そこで、単に繰り返しを抑えるだけでなく、ループしている状態から、思考を閉じる状態へ近づけることに着目します。
材料は512問の練習問題に対する、モデル自身の回答です。正解ラベルは使いません。回答の中から、次の三つの部分を取り出します。
- 同じ文章を最初に書いた部分
- その文章を繰り返している部分
- 思考を終える直前の部分
繰り返し中と終わる直前の内部状態の差から、調整する方向を決めます。さらに、同じ文章を二回目に書くときにその方向への出力が強くなる箇所を選びます。これにより、通常の思考よりも、ループに入ったときに編集が強く働くようにします。
変更するのは二つの層で、それぞれ64個のニューロンに関わる部分です。編集対象は合計131,072個の重み、モデル全体の約0.016%。層の位置と変更の強さは先行研究とそろえ、方向と対象の選び方を比較しました。
小さな変更で、最後まで答えられる問題が増えた
編集の作成にはGPU一枚で84分かかりました。MATH-500の正答率は、先行研究の49.7%に対して 56.3%。三回の実験の平均です。
| Qwen3.5-0.8Bの条件 | MATH-500 正答率 | 上限で打ち切り | GSM8K 正答率 |
|---|---|---|---|
| 編集前 | 7.4% | 93.0% | 13.8% |
| 先行研究の編集 | 49.7% | 32.1% | 67.4% |
| CLC-sel | 56.3% | 17.7% | 69.0% |
別の数学問題GSM8Kでも、正答率が67.4%から69.0%に上がりました。生成トークン数は平均12,000から9,100へ減り、約24%少ない出力で答えています。
増えたのは、解答を出せる機会
両方の編集で最後まで答えられた問題だけを比べると、正答率は74.0%と74.9%で、ほぼ同じでした。全体の差の多くは、先行研究の編集では打ち切られ、CLC-selでは完了できた問題から生まれています。
つまり、ループの中で失われていた解答を取り戻したことが、今回の改善につながっています。回答を最後まで出すこと自体が、小さな推論モデルの使いやすさを左右するという結果です。
今回の比較は一つのモデルと二つの数学ベンチマークで行っています。編集の考え方を見つけたのは先行研究のエージェントで、その仕組みを短い手順にしたのがCLC-selです。探索で見つけた知見を、繰り返し使える実装へ落とす例としても面白い研究です。