David
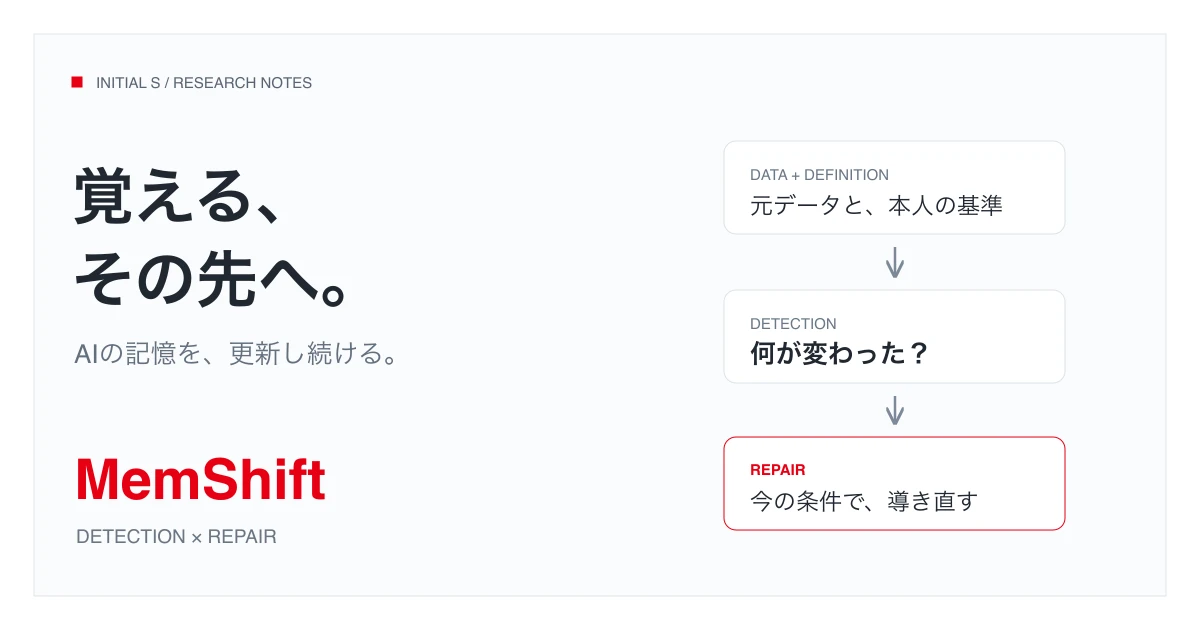
くらちゃんや、Agentのデータと記憶を支えるData Brainを開発する中で、私たちは「一度覚えたことを、どう更新し続けるか」という問題に向き合ってきました。この問題を扱う私たちの共同研究論文が MemShift です。記憶の変更に気づくことと、新しい内容に直すことを分けて調べました。
昨日は正しかった記憶が、今日は古い
たとえば、AIが「あなたの重要な連絡先はAさんとBさんです」と覚えていたとします。判断の基準は「直近30日で、個別の打ち合わせを3回以上した相手」。カレンダーを集めて数えた結果です。
この記憶は、特定の一通のメールをそのまま保存したものとは違います。複数の記録と、本人の決めた基準から作られています。予定が修正されたり、打ち合わせが削除されたりすれば、結果も変わります。「3回以上」を「5回以上」に変えても同じです。
さらに、何も追加されなくても時間は進みます。昨日は直近30日に入っていた打ち合わせが、今日は範囲から外れるかもしれません。
AIの記憶には、保存した文章を見つける仕事に加えて、今の条件でも正しいかを見直す仕事があります。MemShiftは、この更新の過程を評価する研究です。
「気づく」と「直す」を別々に見る
更新には、二つの段階があります。
- 変更に気づく:元の記録や基準が変わり、どの記憶を見直すべきか判断する。
- 内容を直す:現在の記録と基準を使い、正しい内容を作り直す。
予定が木曜日へ変わったのに、水曜日と答えた場面を考えてみます。変更を取り込めていなかったのかもしれません。変更は見つけたものの、古い予定を混ぜて読み直してしまったのかもしれません。回答だけを見ると同じ間違いですが、必要な修正は違います。
変更を見逃しているなら、更新の合図や記録とのつながりを見直す。変更を検知できているなら、再計算の方法や渡す情報を見直す。この区別が、論文の中心です。
一年分の生活記録を使って比べる
実験では、メール、チャット、カレンダー、連絡先、タスク、ノートからなる、架空の12か月の生活記録を作りました。一つの世界に約1,500〜1,650の出来事があり、48項目の記憶を評価します。
勤務先や予定のような項目に加え、「重要な連絡先」「親しい友人」「進行中のプロジェクト」など、基準に沿って集計する項目も含めました。
| 変えるもの | 例 | 見たいこと |
|---|---|---|
| 元の記録 | 会議の日時が変わる | 変更した予定を答えられるか |
| 記録の削除 | 会議がなくなる | 取り消した内容を覚え続けないか |
| 判断の基準 | 「3回以上」を「5回以上」へ | 同じ記録から答えを作り直せるか |
| 記憶を作るモデル | 別のモデルへ切り替える | それまでの内容を維持できるか |
| 記憶の移動 | 別の実装へエクスポートする | 移動後も更新を続けられるか |
正しい日付や人物の集合などを先に決めてから文章を生成し、採点時に照合します。別のAIに「この答えはよさそうか」と評価させる方式ではありません。条件を固定することで、どの変更で記憶が崩れたかを追えるようにしています。
特に基準の変更では、メールや予定の内容は変えません。それでも答えは変わるため、単に新着メッセージを追加するだけの仕組みとの差が見えます。
更新の合図を足しただけでは、直らなかった
実験用の仕組み HoldMem では、情報源のイベント数、定義のバージョン、記憶を書いたモデルを記録します。これらが変わると、古い記憶を見直す合図にします。
そのうえで、内容を直す方法を三つ比べました。AIが文章を読み直す方法、AIが書いたプログラムで集計する方法、正解を作るものと同じ規則で再計算する方法です。
Qwen3.5-9Bを使い、20の架空の生活記録で「判断の基準を変更した後」を調べた結果が次の表です。対象は、答えが変わった558の項目・時点です。
| 内容を直す方法 | 更新の合図なし | 更新の合図あり |
|---|---|---|
| AIが読み直す | 26.9% | 27.1% |
| AIが書いたプログラムで計算 | 45.0% | 70.4% |
| 正解と同じ規則で再計算 | 64.7% | 91.6% |
AIが読み直す方法では、合図を足しても正答率はほとんど変わりませんでした。一方、計算の方法を変えると、合図を足す効果が大きくなります。変更に気づく仕組みは、正しく直す仕組みと組み合わせて初めて効くことが分かります。
最後の行は、正解を生成する規則を使った比較です。「再計算が正しければ、どこまで改善できるか」を見るために置いています。また、この実験の合図は情報源全体を監視するため、変わっていない記憶も多く作り直します。更新漏れを減らした後には、どこだけを更新するかという課題が残ります。
条件が明確な集計は、プログラムに任せる
「直近30日で3回以上会った人」を探すなら、必要な処理は日付で絞り、人物ごとに数えることです。毎回すべての予定を文章として読み直すより、決めた条件を実行する形にできます。
AIには、本人の言葉を計算の条件に変える役割を持たせます。記録を数える処理はプログラムが担当します。説明用のPythonでは、次のように書けます。
from collections import Counter
from datetime import timedelta

def important_contacts(live_meetings, now, days=30, minimum=3):
    cutoff = now - timedelta(days=days)
    counts = Counter(
        meeting["person"]
        for meeting in live_meetings
        if meeting["one_off"]
        and cutoff <= meeting["at"] <= now
    )
    return sorted(
        person for person, count in counts.items()
        if count >= minimum
    )
この例では、削除済みの予定を除いた現在の記録を入力します。日時は同じ基準でそろえ、回数や期間が変われば値を変更します。日が進んだら、現在時刻で計算し直します。
プログラムで集計できても、それをいつ呼び直すかは別に必要です。研究では、削除されたレコードから値を返してしまう失敗もありました。処理を正しく書くことと、現在有効なデータを渡すことの両方が結果を左右します。
集計に渡す情報の範囲も影響します。論文の別比較では、定義に関わる記録をすべて構造化して渡したClaude Sonnet 5.5の正答率は91.8%、選ばれた情報だけを渡す条件では50.0%でした。条件を正しく理解できても、数える対象が手元にそろっていなければ、答えは変わってしまいます。
そのため、更新の設計では、変更の通知、対象のデータ、計算の方法を一続きで確認します。「再計算を実行した」というログの次に、何を入力し、どの条件で結果を作ったかも追えるようにします。
前の答えの引用先だけでは、変化を追い切れない
前回の重要な連絡先がAさんとBさんだったなら、その根拠となった予定を保存しておくと便利です。後から答えを確認できますし、その予定が変わったときにも気づけます。
では、Cさんとの打ち合わせが増えて、新しく条件を満たしたらどうでしょう。Cさんの予定は、前回の答えの引用先に入っていません。引用した記録だけを監視していると、新しい候補を見落とします。
記憶の更新には、前回どの資料を使ったかに加え、どの範囲の記録を、どんな条件で探したかも必要です。予定の追加、削除、定義の変更、時間の経過を、その条件に結びつけて扱います。
記憶を移すときは、更新の情報も一緒に
別のモデルやシステムへ記憶を移すとき、文章だけ持ち運べば、今の答えは読めます。しかし、その答えをいつ作り直すべきかまでは分かりません。
論文では、同じデータモデルを使う二つの実装間で移行を試しました。更新に使うキーを含めて移した場合は、移行前と同じ結果を保ちました。キーを除くと、その後の変化を検知できませんでした。
長く使うAIの記憶には、値だけでなく、根拠、判断の基準、更新の合図が必要です。MemShiftは、それぞれを分けて測ることで、古い答えを返したときに直すべき場所を探しやすくしています。
論文・コード
Zichuan Xu, Haochen Zhang, Yuyang Dong, Makoto Onizuka, Chuan Xiao. MemShift: Separating Detection from Repair in LLM-Derived Personal Memory.