David
MeCloudの写真整理を開発する中で、名刺、レシート、それ以外の写真をどう仕分けるかを試しています。ショップカードと名刺は、文字やロゴの配置がよく似ています。見た目の近さだけで選ぶと、別の種類の画像まで名刺として集まってしまいます。
今回は、画像の特徴を取り出す EmbeddingGemma 2 をそのまま使い、最後の仕分けを担当する小さな分類器だけを学習しました。開発中に繰り返し評価している437枚では、正解率が 87.2%から94.5% に上がりました。構成と結果、写真整理で役立ちそうな点を紹介します。
写真を見る部分と、仕分ける部分を分ける
まず、EmbeddingGemma 2で写真を768個の数値に変換します。この数値の並びを「ベクトル」と呼びます。写真の内容や見た目の特徴を、比較や計算に使える形にしたものです。
次に、そのベクトルを小さな分類器へ渡し、「名刺」「レシート」「その他」のどれに近いかを判定します。学習するのは、この最後の部分だけです。画像の特徴を取り出すモデル自体は変更しません。
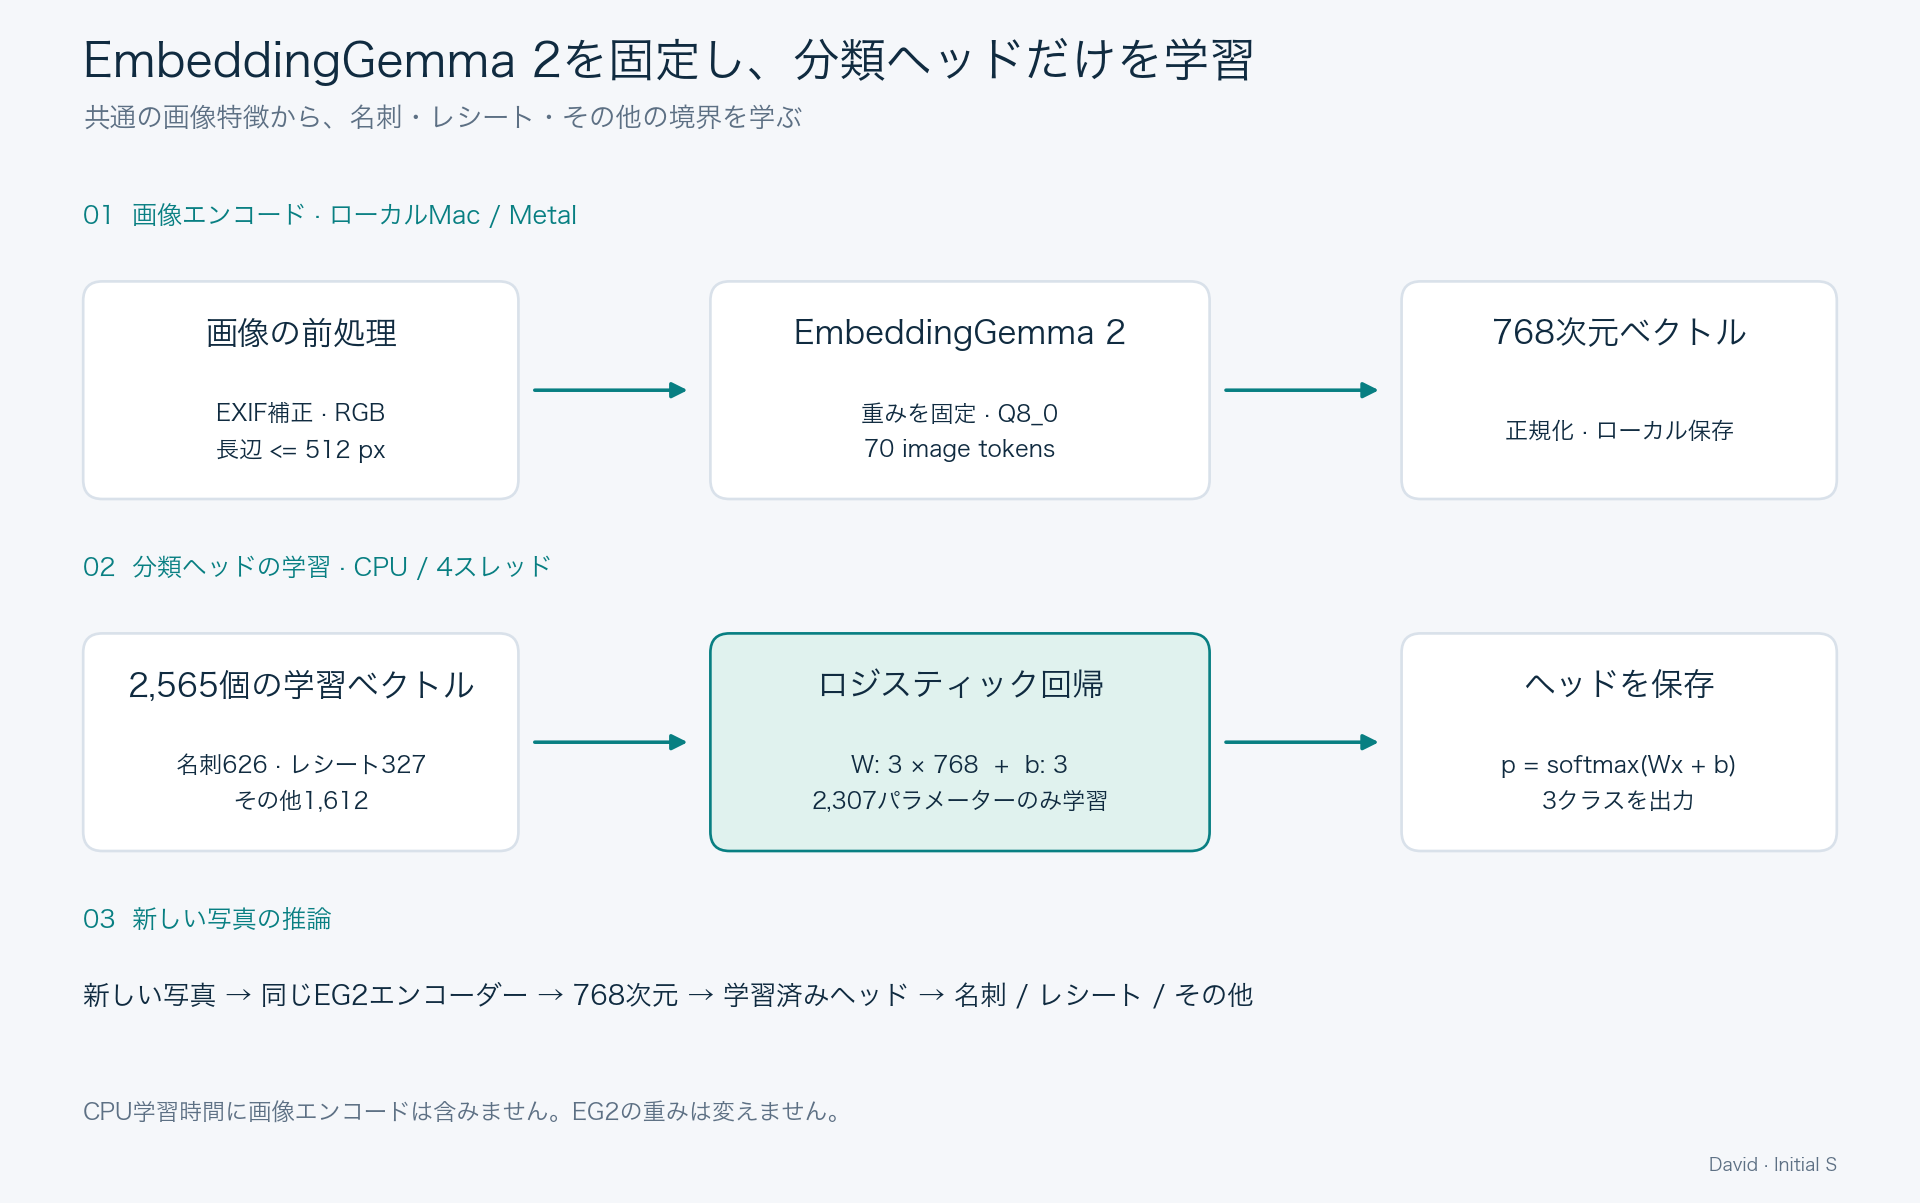
使ったのは、ロジスティック回帰というシンプルな分類器です。三種類の出力に必要な数値は合計2,307個。写真一枚ずつについて文章を生成させる処理や、OCRを追加する処理は入れていません。
画像は向きを補正し、RGBにそろえ、長辺を最大512ピクセルに縮小します。EmbeddingGemma 2はGGUF版のQ8_0を使い、画像トークン数を70、出力を768次元に固定しました。特徴の生成にはMacのMetalを使い、生成済みのベクトルを保存して再利用しています。
この分け方なら、写真の仕分けルールを変えたときも、同じベクトルを使って小さな分類器を学習し直せます。画像を読む処理と、業務ごとの判定を分けられることが利点です。
「似ている」から「この種類」へ
比較相手は、分類器を学習せずに始められる方法です。「個人の名刺写真」「買い物のレシート写真」のような説明文を用意し、写真と説明文のベクトルがどれくらい近いかを比べます。今回は既存の120個の説明文を使いました。
この方法は準備が少なく、まず動かしてみるには便利です。一方、意味や見た目が似ていても、同じ種類に分けたいとは限りません。店のロゴだけが載ったショップカードは「その他」。店主の名前と個人の連絡先が載った名刺は「名刺」。このような区別を、実例から分類器に覚えさせます。
学習画像は2,565枚です。名刺626枚、レシート327枚、その他1,612枚を使いました。公開データ、印刷事例、合成画像、PDFから作った画像、手元の実写などを組み合わせています。画像と掲載元を照合したラベル確認は主にAIアシスタントで行いました。
名刺は印刷事例の割合が高く、日常で撮影した実写は少なめです。明るい机で正面から撮ったカードと、暗い場所で斜めに撮ったカードでは見え方が違います。この撮影場面の広がりも、次に増やしたいデータの一つです。
同じ437枚で比べる
評価には、名刺91枚、レシート144枚、その他202枚を使いました。手元のNASの170枚と公開サンプル267枚からなる、開発中の固定セットです。両方式に同じ写真を渡し、すべてを三種類のいずれかに分類しました。
| 見た項目 | 説明文との近さで分類 | 小さな分類器を学習 |
|---|---|---|
| 全体の正解数 | 381 / 437枚 | 413 / 437枚 |
| その他を名刺・レシートに間違えた数 | 39枚 | 8枚 |
| 本物の名刺を見つけた数 | 85 / 91枚 | 78 / 91枚 |
全体では、正しく仕分けできた写真が32枚増えました。特に「その他」が名刺やレシートに混ざる件数は、39枚から8枚に減っています。
一方で、本物の名刺を見つけた数は85枚から78枚に減りました。分類器が名刺と判断する条件が厳しくなり、似た画像を除けるようになった反面、本物も一部逃しています。
これは画面の使い方にも関わります。自動で名刺フォルダを作るなら、関係のない写真が混ざらないことが大切です。探している名刺を一枚も逃したくない検索なら、候補を少し広く見せる設計も考えられます。全体の正解率と、何を見逃したかを一緒に見る理由です。
レシートでは、実物を見つける割合が92.4%から97.9%へ上がりました。「名刺」「レシート」「その他」をまとめた平均だけでなく、種類ごとの変化を追うと、次に直したい部分が分かります。
学習は、用意したベクトルから約0.06秒
学習には、24GBメモリのMacBook Air M3とCPU四スレッドを使いました。2,565枚分のベクトルを用意した後、分類器の学習にかかった時間は 0.057秒 です。
scikit-learnでの学習部分は、次のコードです。X_trainには768次元の画像ベクトル、y_trainには三種類のラベルを渡します。
from sklearn.linear_model import LogisticRegression

head = LogisticRegression(
    C=100,
    class_weight="balanced",
    solver="lbfgs",
    max_iter=3000,
    random_state=20261015,
)
head.fit(X_train, y_train)class_weight="balanced"は、枚数の少ない種類にも重みを持たせる設定です。今回の比較では、この設定や判定の基準を固定し、評価の結果を見てパラメーターを探す調整はしていません。
生成済みのベクトル一件の判定は、中央値で約0.006ミリ秒でした。これらは分類器だけの計測です。新しい写真を読み込み、縮小して、EmbeddingGemma 2でベクトルを作る時間は別にかかります。すでに写真検索用のベクトルがある場面では、仕分けの追加処理を軽くできます。
次に増やすのは、違う場面の写真
この実験で効いたのは、モデル全体を学習し直すことではなく、すでにある特徴に「どう分けたいか」を加えることでした。小さな分類器でも、ショップカードのような紛らわしい例を区別する助けになります。
次に重視したいのは、別の人、別の発行元、別の撮影環境の名刺です。同じ名刺を角度違いで十枚集めることと、十人がそれぞれの場面で撮った写真を集めることでは、学べる違いも変わります。
今回の437枚は継続して使っている開発用セットです。次は新しく集めた実写で、関係のない画像を除く効果を保ちながら、本物の名刺をどれだけ取り戻せるかを確かめます。